
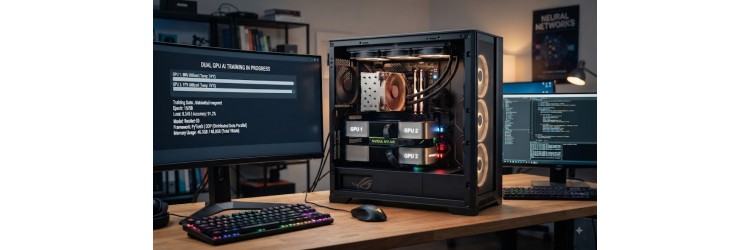
Yapay zeka teknolojilerinin ve derin öğrenme modellerinin hızla gelişmesi, donanım gereksinimlerini de doğrudan yukarı taşıyor. Özellikle büyük dil modelleri (LLM), bilgisayarlı görü projeleri ve karmaşık sinir ağları eğitilirken standart donanımlar bir süre sonra yetersiz kalabiliyor. Bu noktada geliştiriciler ve veri bilimciler, işlem gücünü artırmak ve bellek sınırlarını aşmak için çoklu GPU mimarilerine yöneliyorlar. Çift ekran kartı yapay zeka projelerinde sadece bir lüks değil, büyük veri setleriyle çalışırken iş akışını hızlandıran temel bir ihtiyaç haline gelebiliyor.
Ancak iki adet ekran kartını sisteme takıp doğrudan çalıştırmak her zaman yeterli olmayabilir. Donanımsal uyumluluktan yazılımsal kütüphane ayarlarına, güç kaynağından termal yönetime kadar birçok detayın dikkate alınması gerekir. Bu yazıda, derin öğrenme süreçlerinizde çift GPU kullanımının mantığını, sağladığı avantajları ve sisteminizi en verimli şekilde nasıl yapılandırabileceğinizi ele alacağız.
Yapay Zeka Eğitiminde Çoklu GPU Kullanımının Avantajları
Yapay zeka modellerinin eğitilmesi (training) süreci, devasa matris çarpımları ve yoğun paralel işlem gücü gerektirir. Tek bir GPU belirli bir kapasiteye kadar yanıt verse de, model büyüdükçe VRAM (video belleği) darboğazı kaçınılmaz olur. Çift ekran kartı kullanmanın en büyük avantajı, VRAM kapasitesini iki katına çıkarmak veya verileri iki kart arasında bölüştürerek işlem süresini dramatik ölçüde kısaltmaktır.
Derin öğrenme projelerinde bellek yetersizliği (Out of Memory - OOM) hatası, geliştiricilerin en sık karşılaştığı engellerden biridir. İki kart kullanıldığında, modelin katmanları farklı kartlara dağıtılarak (Model Parallelism) veya büyük veri setleri mini-batch'ler halinde eş zamanlı işlenerek (Data Parallelism) bu sınırların üzerine çıkılabilir. Böylece tek kartın sığdıramayacağı devasa modeller rahatlıkla eğitilebilir.
Güçlü bir sistem altyapısı kurarken doğru bileşenleri seçmek kritik önem taşır. İşlemci ve anakart uyumluluğunun yanı sıra, doğru ekran kartları seçimi tüm yapay zeka pipeline'ınızın performansını doğrudan belirler. Ekran kartlarının sunduğu CUDA çekirdekleri, Tensor çekirdekleri ve yüksek bant genişliğine sahip bellekler, eğitim süresini saatler hatta günler mertebesinde kısaltabilir.
Donanım Uyumluluğu: Anakart, Güç Kaynağı ve Soğutma
Sisteminize ikinci bir ekran kartı eklemeden önce anakartınızın fiziksel ve teknik altyapısını incelemeniz gerekir. İki ekran kartını tam performansla (genellikle PCIe 4.0 veya 5.0 x16 hızlarında) çalıştırmak için yeterli PCIe veri yolu hattına ve uygun fiziksel slot aralığına sahip bir anakart şarttır. Slotların birbirine çok yakın olması, kartların hava akışını engelleyerek aşırı ısınmasına yol açabilir.
Bir diğer hayati bileşen ise güç kaynağıdır (PSU). İki adet yüksek performanslı ekran kartı, özellikle tam yük altında çalıştıkları yapay zeka eğitim süreçlerinde anlık çok yüksek güç tüketimleri (spike) yapabilir. Sistem stabilitesini korumak ve olası kapanmaların önüne geçmek için yüksek sertifikalı, yüksek watt değerine sahip bir güç kaynağı kullanılmalıdır. Ayrıca kasa içi hava sirkülasyonu ve sıvı soğutma çözümleri, uzun süren eğitim maratonlarında bileşenlerin optimum sıcaklıkta kalmasını sağlar.
Donanım yükseltmesi yaparken işlemci ve bellek (RAM) kapasitesinin de bu oranda dengeli olması gerekir. İşlemci darboğazı yaşamamak adına güçlü bir işlemciler ailesinden seçim yapmak, veri ön işleme (data preprocessing) aşamalarının ekran kartlarını bekletmesini engeller. GPUGaraj üzerinden projenize en uygun bileşenleri inceleyerek dengeli bir iş istasyonu toplayabilirsiniz.
Yazılım Yapılandırması: PyTorch ve TensorFlow ile Çift GPU
Donanım montajı tamamlandıktan sonra sıra yazılımsal optimizasyona gelir. Modern derin öğrenme kütüphaneleri olan PyTorch ve TensorFlow, çoklu GPU kullanımını (Multi-GPU) oldukça kolaylaştıracak yerleşik API'lere sahiptir. İşletim sisteminizin (Linux veya Windows) ekran kartı sürücülerini ve CUDA/cuDNN kütüphanelerini doğru sürüm eşleşmesiyle kurduğunuzdan emin olmalısınız.
PyTorch'ta torch.nn.DataParallel (DP) veya daha gelişmiş olan torch.nn.parallel.DistributedDataParallel (DDP) yöntemlerini kullanarak kodunuzu birden fazla karta ölçeklendirebilirsiniz. DDP, özellikle çoklu GPU eğitiminde her kartın kendi sürecini (process) yürütmesini sağlayarak iletişim overhead'ini azaltır ve çok daha lineer bir performans artışı sunar.
TensorFlow tarafında ise tf.distribute.MirroredStrategy stratejisi sıklıkla tercih edilir. Bu strateji, modeli tüm mevcut GPU'lara kopyalar ve veri setini batch'lere bölerek her karta eşit iş yükü dağıtır. Eğitim bittikten sonra ağırlıklar senkronize edilir. Bu yapılandırmalar sayesinde yazılım kodunuzda büyük değişiklikler yapmadan, sadece birkaç satır ekleyerek çift ekran kartının gücünü tam kapasite devreye sokabilirsiniz.
Çift Ekran Kartı Kullanırken Dikkat Edilmesi Gereken İpuçları
Çift ekran kartı ile yapay zeka eğitimi yaparken karşılaşılabilecek bazı pratik zorluklar ve bunların çözümleri vardır:
Termal Yönetim: İki kart üst üste veya çok yakın bindiğinde alt taraftaki kart üsttekinin sıcak havasını çekebilir. Kasada yeterli fan desteği olduğundan emin olun.
PCIe Bant Genişliği: Çoklu kart kullanımında anakartın PCIe hat paylaşımını kontrol edin. Bazı anakartlar ikinci karta takıldığında x16 hızını x8'e düşürebilir; bu durum veri transferini bir miktar etkileyebilir.
Batch Boyutu Optimizasyonu: VRAM iki katına çıktığı için batch boyutunu (batch size) artırarak eğitim verimliliğini yükseltebilirsiniz, ancak gradyan patlamalarına karşı öğrenme oranını (learning rate) yeniden kalibre etmeniz gerekebilir.
Güç Dağıtımı: PSU üzerindeki kablolama düzeninin her iki karta da bağımsız ve yeterli güç hatlarıyla (12VHPWR veya çoklu 8-pin) bağlandığından emin olun.
Sıkça Sorulan Sorular
Çift ekran kartı kullanmak VRAM miktarını birleştirir mi?
Standart veri paralel mimarilerinde her kart kendi belleğinde çalışır ve VRAM doğrudan toplanmaz; ancak model paralelliği kullanıldığında büyük bir model farklı kartların belleklerine bölünerek çalıştırılabilir.
Yapay zeka için hangi marka ekran kartı tercih edilmelidir?
Endüstride CUDA ekosisteminin yaygınlığı ve kütüphane desteği nedeniyle genellikle NVIDIA tabanlı kartlar öncelikli olarak tercih edilmektedir.
İki farklı model ekran kartını birlikte kullanabilir miyim?
Teknik olarak mümkündür, ancak derin öğrenme eğitiminde senkronizasyon sorunları yaşamamak ve eşit performans almak için aynı model ve VRAM kapasitesine sahip iki kartın kullanılması önerilir.
Çift GPU için SLI veya CrossFire gerekli mi?
Hayır. Oyunlarda kullanılan SLI teknolojisi yapay zeka eğitimi için gerekli değildir. Derin öğrenme kütüphaneleri kartları doğrudan PCIe veri yolu üzerinden yönetir.