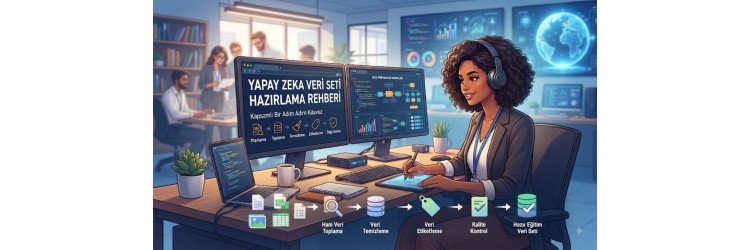
Yapay zeka ve makine öğrenmesi projelerinin başarısı, doğrudan beslendikleri verinin kalitesine bağlıdır. Ne kadar güçlü donanımlara sahip olursanız olun, girdiğiniz veri hatalı veya düzensizse modeliniz de aynı oranda yanıltıcı sonuçlar üretecektir. Bu nedenle veri seti hazırlama süreci, her yapay zeka geliştiricisinin üzerinde titizlikle durması gereken en temel aşamadır. Doğru veri toplama, titiz bir temizleme süreci ve doğru etiketleme adımları, modelinizin başarısını doğrudan belirler.
Veri hazırlama yolculuğu sadece ham bilgiyi bir araya getirmekten ibaret değildir. Verinin türü, boyutu, depolandığı disklerin hızı ve işleme sırasında kullanılan bileşenlerin gücü tüm süreci etkiler. Özellikle büyük veri setleri ile çalışırken yapay zeka için kaç GB RAM gerekir sorusunun yanıtı, sisteminizin tıkanmadan çalışması açısından büyük önem taşır. Bu kapsamlı rehberde, sıfırdan kusursuz bir veri setini nasıl oluşturabileceğinizi adım adım ele alacağız.
Veri Toplama Stratejileri ve Kaynak Belirleme
Herhangi bir yapay zeka modelini eğitmek için öncelikle kaliteli ve amaca uygun ham verilere ihtiyaç vardır. Veri toplama aşamasında izleyeceğiniz strateji, modelinizin çözmesini istediğiniz probleme doğrudan hizmet etmelidir. Örneğin bir görüntü işleme modeli eğitecekseniz yüksek çözünürlüklü görsellere, metin tabanlı bir dil modeli geliştirecekseniz ise zengin ve bağlamsal metin havuzlarına ihtiyacınız olacaktır.
Veri toplarken açık kaynaklı platformlardan, web scraping (veri kazıma) yöntemlerinden veya kendi ürettiğiniz sentezlenmiş verilerden yararlanabilirsiniz. Ancak hangi kaynağı seçerseniz seçin, verinin telif haklarına uygun ve yasal olduğundan emin olmalısınız. Ayrıca topladığınız verilerin çeşitliliği, modelinizin gerçek dünya senaryolarında karşılaşabileceği farklı durumlara karşı dayanıklılığını artırır. Tek tip verilerle beslenen modeller genellikle ezberleme (overfitting) eğilimi gösterir.
Veri toplama sürecinde büyük dosyalarla çalışırken depolama biriminizin okuma ve yazma hızları iş akışınızı doğrudan etkiler. Veri okuma darboğazı yaşamamak adına yapay zeka için SSD seçimi ve en iyi modeller incelemelerine göz atarak sisteminize en uygun yüksek hızlı depolama çözümünü entegre edebilirsiniz. Hızlı SSD'ler, model eğitim döngüleri sırasında verinin RAM'e ve GPU'ya aktarım süresini minimuma indirir.
Veri Temizleme ve Gürültü Azaltma Adımları
Ham veriler doğası gereği eksik, hatalı, mükerrer veya gürültülü (anlamsız karakterler, bozuk pikseller vb.) olabilir. "Çöp girerse çöp çıkar" kuralı yapay zekada kesinlikle geçerlidir. Bu yüzden veri temizleme aşaması, toplamadan bile daha fazla zaman alabilir. Bu aşamada yinelenen kayıtlar ayıklanır, eksik veriler doldurulur ya da tamamen veri setinden çıkarılır.
Metin tabanlı veri setlerinde yazım hatalarının düzeltilmesi, gereksiz HTML etiketlerinin temizlenmesi ve noktalama işaretlerinin standardize edilmesi gerekir. Görsel veri setlerinde ise bulanık, yanlış etiketlenmiş veya düşük kaliteli fotoğraflar ayıklanmalıdır. Verinin temiz ve tutarlı olması, modelin öğrenme eğrisini hızlandırır ve gereksiz parametre güncellemelerinin önüne geçer.
Temizleme ve önişleme adımları sırasında işlemciye binen yük oldukça fazladır. Çok çekirdekli ve yüksek performanslı bir işlemci, devasa veri setlerinin temizlenmesini ve dönüştürülmesini saniyeler içinde tamamlayabilir. İş yükünüze en uygun bileşeni belirlemek için yapay zeka iş yükü için işlemci seçimi rehberinden faydalanabilir, veri işleme hızınızı zirveye taşıyabilirsiniz.
Veri Etiketleme ve Sınıflandırma Yöntemleri
Denetimli öğrenme (supervised learning) algoritmalarıyla çalışıyorsanız, temizlenen verilerin doğru bir şekilde etiketlenmesi şarttır. Etiketleme kalitesi, modelin tahmin başarısını doğrudan etkileyen en kritik unsurdur. Yanlış etiketlenmiş veriler, yapay zekanın yanlış örüntüler öğrenmesine ve dolayısıyla hatalı kararlar vermesine neden olur.
Etiketleme sürecini manuel olarak yapmak küçük veri setlerinde mümkün olsa da, büyük ölçekli projelerde otomatik etiketleme araçlarından veya yarı otomatize edilmiş yazılımlardan destek almak gerekir. Görsel veri setlerinde nesne tespiti içinBounding Box (sınırlayıcı kutu) teknikleri kullanılırken, metin projelerinde duygu analizi veya varlık tanıma (NER) etiketleri uygulanır.
Etiketleme ve model eğitimi sırasında donanımınızın gücü kadar soğutma performansı da hayati önem taşır. Uzun süren veri işleme ve eğitim seanslarında bileşenlerin ısı sınırlarını aşmaması gerekir. Sistem kararlılığını korumak ve donanım ömrünü uzatmak adına yapay zeka donanım soğutma neden önemlidir konusunu inceleyebilir, sıvı veya hava soğutma alternatiflerini değerlendirebilirsiniz.
Eğitim, Doğrulama ve Test Verisi Olarak Bölümleme
Hazırladığınız ve etiketlediğiniz veri setini doğrudan tek bir blok halinde modele vermek doğru değildir. Veri seti; eğitim (training), doğrulama (validation) ve test olmak üzere üç temel parçaya bölünmelidir. Bu bölünme genellikle %70 eğitim, %15 doğrulama ve %15 test şeklinde standart oranlarla yapılır.
Eğitim verisi modelin ağırlıklarını güncellemesi için kullanılırken, doğrulama verisi eğitim sırasında modelin ezberleme yapıp yapmadığını kontrol etmek için devreye girer. Test verisi ise modelin daha önce hiç görmediği veriler üzerindeki gerçek performansını ölçmek için en sonda kullanılır. Bu ayrım yapılmazsa modelin gerçek dünyadaki başarısını asla doğru şekilde ölçemezsiniz.
Tüm bu süreçler tamamlandığında, modeli yerel sisteminizde çalıştırmak veya optimize etmek için güçlü ekran kartı mimarilerine ihtiyaç duyarsınız. Özellikle VRAM kapasitesi, büyük veri setlerinin işlenmesinde ve model çıktılarının hızlandırılmasında kilit rol oynar. İhtiyacınıza uygun donanım kombinasyonlarını keşfetmek ve projelerinizi hızlandırmak için hazir-gaming-sistemer sayfasındaki güçlü sistem alternatiflerine göz atabilirsiniz.
Sıkça Sorulan Sorular
Yapay zeka veri seti hazırlarken en sık yapılan hata nedir?
En yaygın hata, verilerin yeterince temizlenmemesi ve aynı türden verilerin veri setini domine etmesidir. Dengesiz veri setleri, yapay zekanın belirli senaryolarda yanılgıya düşmesine sebep olur.
Küçük bir veri seti ile başarılı bir model eğitilebilir mi?
Evet, transfer learning (aktarımlı öğrenme) teknikleri sayesinde küçük veri setleriyle bile oldukça başarılı sonuçlar elde etmek mümkündür. Önceden eğitilmiş modellerin üzerine kendi verilerinizi entegre edebilirsiniz.
Veri seti hazırlamak için özel bir ekran kartı şart mı?
Veri toplama ve temizleme aşamalarında ekran kartından ziyade işlemci ve RAM performansı önemlidir. Ancak büyük modellerin eğitimi ve çıkarım süreçleri için güçlü bir GPU şarttır.
Veri etiketleme süreci nasıl otomatikleştirilebilir?
Önceden eğitilmiş baz modeller (pre-trained models) veya özel etiketleme yazılımları kullanılarak yarı otomatik etiketleme süreçleri kurulabilir, böylece zamandan ciddi tasarruf sağlanır.