
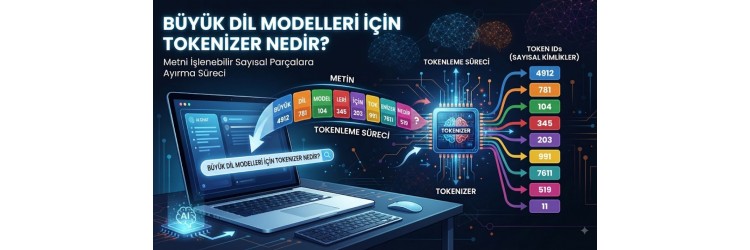
Yapay zeka teknolojilerinin hayatımızın her alanına hızla girdiği günümüzde, büyük dil modelleri (LLM) insan benzeri metinler üretme, çeviri yapma ve karmaşık problemleri çözme konusunda olağanüstü bir başarı sergiliyor. Ancak bu sistemlerin arka planda nasıl çalıştığını anlamak, sadece kodlama bilenler için değil, yapay zeka araçlarını aktif olarak kullanan herkes için önemlidir. Yapay zeka dünyasında modeller doğrudan kelimeleri veya cümleleri anlamaz; bunun yerine matematiksel vektörlerle işlem yaparlar. İşte bu noktada yapay zeka tokenizer devreye girer.
Tokenizer, insan dilini yapay zeka modelinin anlayabileceği sayısal biçimlere dönüştüren kritik bir bileşendir. Bir metni alıp onu modelin işleyebileceği en küçük anlamlı parçalara ayıran bu araç, yapay zeka projelerinin başarısını doğrudan etkiler. Özellikle yerel donanımlar üzerinde Ollama İle Çevrimdışı Yapay Zeka Kullanımı ve Rehberi gibi araçlarla model çalıştırırken, token sınırlarını ve bellek tüketimini optimize etmek performans açısından hayati önem taşır. Bu yazımızda, tokenizer kavramının ne olduğunu, nasıl çalıştığını ve büyük dil modellerindeki hayati rolünü detaylıca inceleyeceğiz.
Tokenizer Nedir ve Temel Amacı Nedir?
En basit tanımıyla tokenizer, ham bir metin dizisini daha küçük parçalara (token'lara) ayıran bir algoritmadır. Bu parçalar bir kelimenin tamamı, bir kelimenin bir hecesi, hatta tek bir harf veya noktalama işareti olabilir. Bilgisayarlar ve yapay zeka algoritmaları metinsel verileri doğrudan işleyemez; verilerin sayısal ID'lere dönüştürülmesi gerekir. Tokenizer, metni bu sayısal dizilere çeviren ilk köprü görevini üstlenir.
Eğer bir yapay zeka modeliyle çalışıyorsanız, sistemin belirli bir bağlam penceresi (context window) ve token limiti olduğunu bilirsiniz. Tokenizer, girilen komutların bu limite uygun şekilde bölünmesini ve modelin belleğine sığmasını sağlar. Yerel Yapay Zeka Modelleri İçin VRAM Önemi (2026) başlıklı yazımızda da değindiğimiz gibi, işlenen her token ekran kartı belleğinde belirli bir yer kaplar. Doğru bir tokenizasyon süreci, donanım kaynaklarının verimli kullanılmasına doğrudan katkı sağlar.
Ayrıca tokenizer'lar sadece metni bölmekle kalmaz; aynı zamanda modeli eğitirken kullanılan sözlüğün (vocabulary) sınırlarını belirler. Model, tokenizer tarafından üretilen bu sayısal ID'ler üzerinden olasılık hesaplamaları yapar ve bir sonraki kelimenin ne olacağını tahmin eder. Bu süreç, modern doğal dil işleme (NLP) sistemlerinin temelini oluşturur.
Büyük Dil Modellerinde Tokenizasyon Yöntemleri Nelerdir?
Yapay zeka tarih boyunca farklı tokenizasyon yaklaşımları denemiştir. İlk dönemlerde kelime bazlı (word-level) tokenizasyon yaygındı ancak bu yöntem, modelin hiç görmediği kelimelerle (Out-of-Vocabulary) karşılaştığında ciddi dezavantajlar yaratıyordu. Günümüzdeki modern büyük dil modelleri ise genellikle alt kelime (subword) tokenizasyon algoritmalarını kullanır.
Bu alanda en popüler yöntemlerden biri BPE (Byte-Pair Encoding) algoritmasıdır. BPE, sık kullanılan kelime öbeklerini tek bir token olarak saklarken, nadir veya karmaşık kelimeleri daha küçük alt parçalara böler. Bu sayede model, daha küçük bir sözlük boyutuyla milyonlarca farklı kelimeyi ve hatta yabancı dilleri başarıyla işleyebilir. Benzer şekilde WordPiece ve Unigram algoritmaları da benzer mantıkla çalışarak metin işleme verimliliğini artırır.
Dil modellerinin farklı dilleri işleme başarısı da büyük ölçüde bu algoritmaların kalitesine bağlıdır. Örneğin, İngilizce bir metin için az sayıda token yeterli olurken, Türkçe gibi sondan eklemeli dillerde kelime kökleri ve ekler farklı şekillerde bölünebilir. Bu durum, Türkçe komutlarda token maliyetlerinin ve işlem sürelerinin değişmesine neden olabilir.
Token Sayısı ve Model Performansı Arasındaki İlişki
Yapay zeka API'leri veya yerel modeller kullanırken maliyetler ve hız genellikle işlenen token sayısı üzerinden hesaplanır. Tokenizer, metninizi modelin tüketeceği para birimine dönüştürür. Ne kadar çok token üretilirse, modelin o kadar çok hesaplama yapması gerekir ve bu da Yapay Zeka Çıkarim Hizi Nasıl Artirilir? sorusunun yanıtını arayanlar için optimizasyon süreçlerini önemli kılar.
Donanım tarafında ise durum benzerdir. Büyük bir veri kümesiyle çalışırken veya model eğitimi yaparken, verinin doğru tokenize edilmesi bellek sızıntılarını ve gereksiz işlem yükünü engeller. Özellikle GPU üzerinde çalışan sistemlerde, Yapay Zeka Donanım Soğutma Neden Önemlidir? başlığı altında ele aldığımız gibi yüksek token yükü işlemcileri ve ekran kartlarını yoğun şekilde çalıştırarak ısı artışına yol açabilir.
Bu nedenle, geliştiriciler ve ileri düzey kullanıcılar projelerinde hangi tokenizer'ın kullanıldığını (örneğin OpenAI'ın tiktoken kütüphanesi veya Hugging Face tokenizer'ları) dikkatle incelemelidir. Yanlış bir tokenizer seçimi, modelin metni yanlış anlamasına veya bağlamı kaçırmasına neden olabilir.
Pratik İpuçları ve Tokenizer Optimizasyonu
Yapay zeka projelerinizde veya günlük model kullanımlarınızda tokenizer verimliliğini artırmak için bazı pratik adımları takip edebilirsiniz:
- Doğru Modeli Seçin: Kullandığınız dil modelinin resmi tokenizer kütüphanesini kullanmaya özen gösterin. Farklı modeller farklı sözlük yapılarına sahiptir.
- Girdi Uzunluğunu Kontrol Edin: Uzun belgeleri modele göndermeden önce mantıklı parçalara ayırarak token sınırlarının aşılmasını önleyin.
- Yerel Kaynakları Optimize Edin: GPUGaraj sistemleri gibi güçlü donanımlar üzerinde yerel modeller çalıştırırken VRAM kapasitenizi göz önünde bulundurun.
- Dil Desteğini Test Edin: Özellikle Türkçe gibi zengin ek yapısına sahip dillerde modelin kaç token harcadığını test araçlarıyla gözlemleyin.
Bu ipuçları, yapay zeka modelleriyle etkileşiminizi daha akıcı hale getirecek ve olası hata oranlarını minimuma indirecektir.
Sıkça Sorulan Sorular (SSS)
1. Tokenizer tam olarak ne işe yarar?
Tokenizer, insan tarafından yazılan metinleri yapay zeka modellerinin matematiksel işlemler yapabilmesi için sayısal kimliklere (token ID) dönüştüren bir yazılım aracıdır.
2. Her yapay zeka modelinin tokenizer'ı aynı mıdır?
Hayır. Her model ailesi (örneğin Llama, GPT, Claude) kendi eğitim sürecine ve sözlük boyutuna uygun özel tokenizer algoritmaları kullanır.
3. Türkçe metinlerde token sayısı neden daha fazla çıkabilir?
Türkçe sondan eklemeli bir dil olduğu için, bazı kelime kökleri ve ekler yabancı tokenizer algoritmaları tarafından daha küçük alt parçalara ayrılarak toplam token sayısının artmasına neden olabilir.
4. Tokenizer maliyetleri nasıl etkiler?
Ticari yapay zeka servisleri ücretlendirmeyi işlenen token miktarı üzerinden yapar. Metin ne kadar çok token üretirse, maliyet de o oranla artar.
5. Yerel yapay zeka çalıştırırken tokenizer değiştirebilir miyiz?
Genellikle hayır. Modelin ağırlıkları belirli bir tokenizer ile eğitildiği için, farklı bir tokenizer kullanmak modelin saçma sonuçlar üretmesine yol açar.