
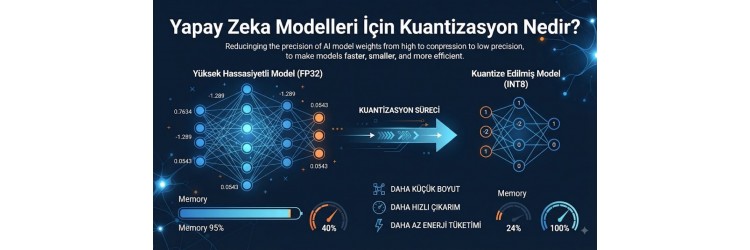
Yapay zeka teknolojilerinin günlük hayatımızın ve profesyonel iş akışlarımızın vazgeçilmez bir parçası haline gelmesiyle birlikte, bu devasa modelleri yerel donanımlarımızda çalıştırma ihtiyacı da katlanarak arttı. Büyük Dil Modelleri (LLM) veya görsel üretim modelleri milyarlarca parametreye sahiptir ve bu parametreler standart durumda devasa bir bellek (VRAM) alanı kaplar. Ev veya ofis kullanıcılarının bu modelleri bütçe dostu donanımlarda çalıştırabilmesi için geliştirilen en kritik tekniklerin başında ise yapay zeka kuantizasyonu gelir.
Kuantizasyon, modelin yapısını bozmadan, sahip olduğu sayısal hassasiyeti düşürerek dosya boyutunu küçültme ve çalışma hızını artırma sürecidir. Bu rehberde kuantizasyonun mantığını, farklı bit seviyelerini ve donanımınıza olan etkilerini derinlemesine inceleyeceğiz.
Kuantizasyon Tam Olarak Nedir ve Nasıl Çalışır?
Temel seviyede yapay zeka modelleri, parametrelerini temsil etmek için kayan noktalı sayılar (floating-point numbers) kullanır. Standart eğitim süreçlerinde genellikle 32-bit (FP32) veya 16-bit (FP16) hassasiyet tercih edilir. Bu yüksek hassasiyet seviyesi, modelin en ince detayları öğrenmesini sağlasa da, çıkarım (inference) aşamasında aşırı derecede RAM ve VRAM tüketimine yol açar. Kuantizasyon, bu 32-bit veya 16-bit değerleri daha düşük bitli tam sayılara (örneğin 8-bit, 4-bit hatta 2-bit) dönüştürme işlemidir.
Bu dönüşüm, tıpkı yüksek çözünürlüklü bir RAW fotoğrafın sıkıştırılarak daha küçük bir JPEG formatına dönüştürülmesine benzer. Görselde bazen çok küçük detaylar kaybolabilir ancak insan gözü bunu fark edemez. Benzer şekilde, doğru algoritmalarla yapılan kuantizasyon işlemlerinde modelin zeka seviyesi (perplexity) çok minimal düzeyde etkilenirken, donanım gereksinimleri dramatik ölçüde düşer. Özellikle yerel LLM çalıştırmak isteyenler için bu optimizasyon, yerel yapay zeka modelleri için VRAM önemi göz önüne alındığında hayati bir adımdır.
Farklı Kuantizasyon Seviyeleri: INT8, INT4 ve GGUF Formatları
Kuantizasyon dünyasında modelinizi dönüştürebileceğiniz veya hazır indirebileceğiniz çeşitli formatlar ve bit seviyeleri bulunur. İhtiyacınıza ve donanım gücünüze göre doğru seviyeyi seçmek, performans ve kalite dengesini korumanın anahtarıdır:
- FP16 / BF16: Neredeyse hiç kayıp yaşamayan orijinal hassasiyete yakın formatlardır ancak çok yüksek VRAM kapasitesi isterler.
- INT8 (8-bit): Bellek tüketimini yarı yarıya azaltırken kalite kaybı neredeyse sıfıra yakındır. Çoğu modern ekran kartı tarafından kusursuz desteklenir.
- INT4 (4-bit): GGUF ve AWQ gibi popüler formatlarda sıkça kullanılır. Devasa modellerin bile standart bir oyuncu bilgisayarında çalışmasına olanak tanır. Kalite düşüşü kabul edilebilir sınırlar içerisindedir.
Donanımınızın bu süreçlerde en verimli şekilde çalışabilmesi için yapay zeka çıkarım hızı nasıl artırılır rehberindeki ipuçlarını inceleyebilir, sistem bileşenlerinizin güncel olduğundan emin olabilirsiniz.
Donanım Uyumluluğu ve Sistem Gereksinimleri
Kuantize edilmiş modelleri çalıştırmak, orijinal devasa modellere kıyasla donanım maliyetlerini ve gereksinimlerini ciddi oranda aşağı çeker. Örneğin, 70 milyar parametreli bir modeli FP16 formatında çalıştırmak için birden fazla üst seviye profesyonel karta ihtiyaç duyulurken, aynı modelin 4-bit kuantize versiyonu tüketici sınıfı ekran kartlarında rahatlıkla calıştırılabilir. Bu bağlamda doğru bir sistem toplamak veya mevcut sistemi güncellemek büyük önem taşır.
Bileşen seçiminde özellikle yüksek hızlı bellekler, güçlü grafik işlemciler ve stabil güç kaynakları öne çıkar. İş istasyonunuzu veya oyun bilgisayarınızı bu tür yoğun iş yüklerine hazırlarken yapay zeka modelleri için PSU seçimi nasıl yapılır yazımıza göz atarak sistemin kararlılığını güvence altına alabilirsiniz. Güçlü bir altyapı, uzun süreli model eğitimlerinde ve yoğun çıkarım testlerinde sistemin kararlı kalmasını sağlar.
Kuantizasyonun Avantajları ve Dezavantajları Nelerdir?
Her mühendislik kararında olduğu gibi kuantizasyonun da artı ve eksi yönleri bulunmaktadır. Bu teknolojiyi projelerinizde veya günlük kullanımınızda uygulamadan önce dengeleri iyi tartmanız gerekir.
Avantajları:
- Düşük VRAM Tüketimi: Büyük modelleri daha küçük VRAM kapasitesine sahip kartlarda çalıştırma imkanı sunar.
- Artan Çıkarım Hızı: Veri yolu bant genişliği ihtiyacı azaldığı için token üretim hızı (tokens per second) belirgin şekilde artar.
- Maliyet Tasarrufu: Çok pahalı veri merkezi donanımları yerine standart tüketici donanımlarıyla yapay zeka geliştirme ve test etme olanağı tanır.
Dezavantajları:
- Hassasiyet Kaybı: Aşırı düşük bit seviyelerinde (örneğin 2-bit veya 3-bit) modelin mantık yürütme yeteneğinde ve halüsinasyon oranında olumsuz değişimler görülebilir.
- Dönüşüm Süreci: Kendi modelinizi kuantize etmek ek hesaplama gücü ve teknik bilgi gerektirir.
Sıkça Sorulan Sorular
Kuantizasyon modelin zekasını tamamen bozar mı?
Doğru bit seviyesi seçildiğinde (örneğin INT4 veya INT8), modelin zeka kaybı insan kullanımında neredeyse hissedilmeyecek kadar azdır. Ancak aşırı agresif sıkıştırmalar mantıksal hatalara yol açabilir.
Her yapay zeka modeli kuantize edilebilir mi?
Evet, teorik olarak tüm ağırlık temelli derin öğrenme ve dil modelleri kuantizasyon işlemine tabi tutulabilir. Günümüzde GGUF, GPTQ ve AWQ gibi standartlar bu süreci oldukça kolaylaştırmıştır.
Kuantizasyon için ekran kartı zorunlu mu?
Kesinlikle zorunlu değildir. İşlemci (CPU) üzerinden de kuantize edilmiş modeller çalıştırılabilir; ancak ekran kartı (GPU) kullanımı hızı katbekat artıracaktır.
Hangi kuantizasyon formatını tercih etmeliyim?
Genel kullanım ve yerel LLM çalıştırma senaryolarında, hem hız hem de kalite dengesini en iyi koruyan 4-bit veya 5-bit GGUF formatları kullanıcılar tarafından sıklıkla tercih edilmektedir.