Yapay zeka ve derin öğrenme modellerinin hayatımızın her alanına girmesiyle birlikte, bu modellerin eğitim süreleri kadar çıkarım (inference) hızları da kritik bir öneme sahip hale geldi. Özellikle gerçek zamanlı çalışan uygulamalarda, büyük dil modellerinde (LLM) veya bilgisayarlı görü projelerinde milisaniyeler bile büyük fark yaratabilmektedir. NVIDIA'nın geliştirdiği TensorRT, tam da bu noktada donanım potansiyelini maksimum düzeyde kullanarak yapay zeka iş yüklerini hızlandırmak için tasarlanmış güçlü bir SDK'dır.
Bu kapsamlı rehberde, TensorRT optimizasyonu kavramının ne olduğunu, modellerinizi bu teknoloji ile nasıl dönüştürebileceğinizi ve çıkarım süreçlerinizde devasa hız artışlarını nasıl elde edebileceğinizi adım adım inceleyeceğiz. Doğru donanım altyapısı ve yazılım yapılandırmasıyla projelerinizde verimliliği zirveye taşıyabilirsiniz.
TensorRT Nedir ve Model Hızlandırma Nasıl Sağlar?
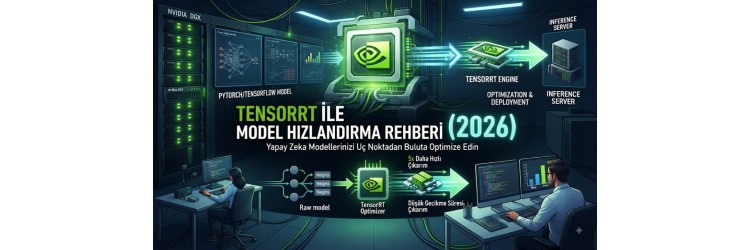
TensorRT, derin öğrenme çıkarım uygulamaları için yüksek performanslı bir SDK'dır. Temel amacı, eğitilmiş sinir ağı modellerini NVIDIA GPU'lar üzerinde en yüksek verimlilikle çalıştırmaktır. Model optimizasyonu sırasında gereksiz katmanları birleştirir, hassasiyet kalibrasyonu yapar ve hedef donanıma en uygun kernel seçimini gerçekleştirerek gecikme sürelerini ciddi oranda düşürür.
Geleneksel olarak PyTorch veya TensorFlow gibi framework'ler üzerinden çalışan modeller, donanım kaynaklarını her zaman en optimum şekilde kullanamayabilir. TensorRT optimizasyonu ise modeli analiz ederek katman füzyonu (layer fusion) uygular. Örneğin ardışık gelen ReLU, Bias ve Convolution katmanlarını tek bir operasyonda birleştirerek bellek bant genişliği tasarrufu sağlar. Bu sayede GPU üzerindeki işlem birimleri kesintisiz ve çok daha hızlı veri işler.
TensorRT Optimizasyonu İçin Gereksinimler ve Hazırlık
Bir modeli TensorRT ile hızlandırmadan önce uygun bir donanım ve yazılım altyapısına sahip olmanız gerekir. Temel olarak bir NVIDIA ekran kartı ve güncel CUDA sürücüleri bu sürecin olmazsa olmazıdır. Projelerinizin ölçeğine göre güçlü bir Nvidia Ekran Kartları ailesinden bir model seçmek, işleme sürelerinizi doğrudan kısaltacaktır. Gelişmiş yapay zeka modelleri yüksek VRAM kapasitesi gerektirdiği için donanım seçimi büyük önem taşır.
Yazılım tarafında ise modelinizi öncelikle standart bir ara formata, genellikle ONNX (Open Neural Network Exchange) formatına dönüştürmeniz gerekir. PyTorch veya TensorFlow formatındaki bir modeli doğrudan TensorRT'ye aktarmak yerine, ONNX formatına export etmek standart bir endüstri pratiğidir. Bu aşamada modelin dinamik boyut (dynamic shape) ayarlarını ve girdi/çıktı katmanlarını doğru tanımladığınızdan emin olmalısınız.
Adım Adım TensorRT Modeli Oluşturma Süreci
Modelinizi ONNX formatına getirdikten sonra, TensorRT motorunu (engine) oluşturmak için Python veya C++ API'lerini kullanabilirsiniz. Sürecin ilk adımı, TensorRT Builder nesnesini başlatmak ve ağ (network) tanımını okumaktır. Bu aşamada ağın yapısı çözümlenir ve optimize edilmeye hazır hale getirilir.
İkinci adımda hassasiyet (precision) ayarlarının yapılması gerekir. TensorRT, FP32 (tek duyarlılık) yerine FP16 (yarı duyarlılık) veya INT8 (tam sayı) hassasiyetlerinde çalışmayı destekler. Özellikle INT8 kalibrasyonu, model doğruluğundan neredeyse hiç ödün vermeden çıkarım hızını katbekat artırabilir. Kalibrasyon aşamasında modelinize örnek veri setleri vererek katmanların dinamik aralıkları belirlenir ve motor dosyası (serialized engine) diske kaydedilir.
Performans Artışı İçin Pratik İpuçları
TensorRT optimizasyonu yaparken elde edeceğiniz hız artışı, modelinizin mimarisine ve kullandığınız donanıma göre değişiklik gösterir. Doğru konfigürasyonlarla projelerinizde maksimum verimi almak için şu ipuçlarını dikkate alabilirsiniz:
Dinamik Girdi Boyutları: Eğer uygulamanız farklı boyutlarda görseller veya metinler alıyorsa, builder aşamasında min, opt ve max profillerini doğru tanımlayın.
Katman Füzyonu Kontrolü: Desteklenmeyen özel operasyonlar varsa, bunları TensorRT'nin plugin mekanizması ile C++ veya Python üzerinden ekleyin.
Bellek Yönetimi: Çıkarım sırasında GPU bellek tahsisini (allocation) en aza indirmek için pinned memory ve stream kullanımına özen gösterin.
GPUGaraj olarak sistem toplama ve donanım tavsiyelerinde her zaman iş yüküne uygun bileşenlerin seçilmesini öneriyoruz. Yapay zeka ve derin öğrenme projelerinizde kesintisiz performans için güçlü bir Hazir Gaming Sistemler tercih edebilir, ekran kartı gücünü en üst düzeyde kullanabilirsiniz.
Sıkça Sorulan Sorular
Her yapay zeka modeli TensorRT ile optimize edilebilir mi?
Çoğu standart derin öğrenme modeli (CNN, Transformer vb.) TensorRT tarafından desteklenir. Ancak özel ve desteklenmeyen custom operasyonlar içeren modeller için eklenti (plugin) yazılması gerekebilir.
INT8 optimizasyonu model doğruluğunu düşürür mü?
Doğru bir kalibrasyon veri seti kullanıldığında, INT8 optimizasyonu model doğruluğunda neredeyse hiç kayıp yaşamadan çıkarım hızını önemli ölçüde artırır.
TensorRT kullanmak için hangi ekran kartları gereklidir?
NVIDIA mimarisine sahip CUDA destekli tüm modern ekran kartlarında TensorRT kullanılabilir. Ancak daha yeni mimarilerdeki Tensor çekirdekleri (Tensor Cores) çok daha yüksek performans sunar.
Modelimi önce neden ONNX formatına çevirmeliyim?
ONNX, farklı derin öğrenme framework'leri arasında köprü görevi görür ve TensorRT'nin modeli daha kolay okuyup optimize etmesine olanak tanır.